Escopo do projeto
Leitura das recomendações do AWS Compute Optimizer para Amazon EC2, grupos do Amazon EC2 Auto Scaling, volumes do Amazon EBS, funções AWS Lambda e instâncias Amazon RDS (RDS for MySQL, RDS for PostgreSQL e Amazon Aurora). Com o Performance Insights ligado, o Compute Optimizer analisa também a carga de sessões e o swap do banco, e só assim gera recomendações de redução de vCPU; ligar o Performance Insights onde falta faz parte da fase Medir. Para os motores que ele não cobre, a RFX lê as métricas diretamente no Amazon CloudWatch. A janela padrão de análise é de 14 dias; quando o ciclo de fechamento do mês precisa entrar na conta, a RFX estende a janela de análise do Compute Optimizer. Validação com o dono de cada sistema: o que é pico legítimo, o que é folga sem uso.
Plano de mudança em ondas, começando pelo que está fora de produção, com janela e rollback por recurso. Inventário de ociosos: volumes desanexados, snapshots órfãos, IPs elásticos sem associação, balanceadores sem destino, instâncias paradas há semanas, bancos sem conexão, a partir do Cost Optimization Hub (recurso do AWS Billing and Cost Management), do AWS Trusted Advisor e do levantamento direto da RFX na conta.
Agendamento de liga e desliga para desenvolvimento, teste e homologação com Amazon EventBridge Scheduler e automações do AWS Systems Manager. Segundo ciclo após 30 dias para capturar o que mudou, e entrega da rotina dos itens Tamanho certo e Ociosos.
Desafio e problemas de hoje
- O ERP roda numa instância escolhida no dia da migração, para um pico que já passou.
- O banco de produção foi dimensionado "com folga" e a folga virou custo fixo.
- Discos de servidores apagados continuam cobrando; ninguém sabe se podem ir embora.
- Ambiente de testes fica ligado 24x7 porque desligar à mão é trabalho.
- Reduzir instância dá medo: ninguém quer ser culpado pela lentidão da segunda-feira.
O ambiente de partida (perfil típico deste exemplo)
| Item | O que costuma existir |
|---|---|
| Computação | De 10 a 60 instâncias Amazon EC2, famílias de gerações antigas, uso médio de CPU e memória bem abaixo do provisionado |
| Banco | De 1 a 6 instâncias Amazon RDS, classes superiores ao necessário, métricas de uso ainda por ler |
| Armazenamento em bloco | Volumes Amazon EBS gp2 em vez de gp3; volumes desanexados; snapshots sem política |
| Ociosos | IPs elásticos soltos, balanceadores sem destino, instâncias paradas, NAT em VPC vazia |
| Horário | Dev, teste e homologação ligados 24x7, usados em horário comercial |
| Restrições | Sistemas sem teste de carga; medo de regressão; janelas só fora do horário |
Perfil típico, com faixas. O retrato real da sua conta é o primeiro entregável do diagnóstico FinOps.
Requisitos
- R1Toda redução baseada em uso medido, com histórico suficiente para cobrir o ciclo do negócio.
- R2Dono de cada sistema valida antes da mudança; janela e rollback definidos por recurso.
- R3Arquitetura preservada; muda só tamanho, tipo de volume e horário.
- R4Ociosos eliminados com evidência (sem uso por N dias) e snapshot antes de apagar quando houver dado.
- R5Liga e desliga automático para ambientes fora de produção, com exceção fácil para o time.
- R6Ganho medido antes e depois no custo por serviço, com o mesmo número de dias.
O que desenhamos para cada requisito
| Requisito | Decisão de arquitetura | Serviço AWS |
|---|---|---|
| R1 | Recomendações do Compute Optimizer com métricas do CloudWatch; memória do EC2 só com o agente do CloudWatch instalado (parte do escopo) ou com a ingestão de métricas de uma ferramenta de observabilidade externa compatível | AWS Compute Optimizer, Amazon CloudWatch |
| R2 | Plano em ondas: dev e teste, depois apoio, depois produção; mudança de tamanho via parada e retomada em janela; rollback é voltar ao tamanho anterior | Amazon EC2, Amazon RDS |
| R3 | Troca de família e tamanho dentro da mesma arquitetura; migração de gp2 para gp3 com o volume em uso | Amazon EC2, Amazon EBS |
| R4 | Lista de ociosos do Cost Optimization Hub (qualquer plano de suporte) e do Trusted Advisor (verificações de custo disponíveis nos planos Business Support+, Enterprise Support e Unified Operations); snapshot antes de apagar volume com dado; registro de cada exclusão | AWS Trusted Advisor, Cost Optimization Hub, Amazon EBS |
| R5 | Agenda por tag (ex.: schedule=comercial) que para e inicia instâncias EC2 e RDS fora do horário; tag de exceção para manter ligado | Amazon EventBridge Scheduler, AWS Systems Manager (Automation) |
| R6 | Comparação do custo por serviço e por tag antes e depois, com o mesmo número de dias | AWS Cost Explorer |
Arquitetura
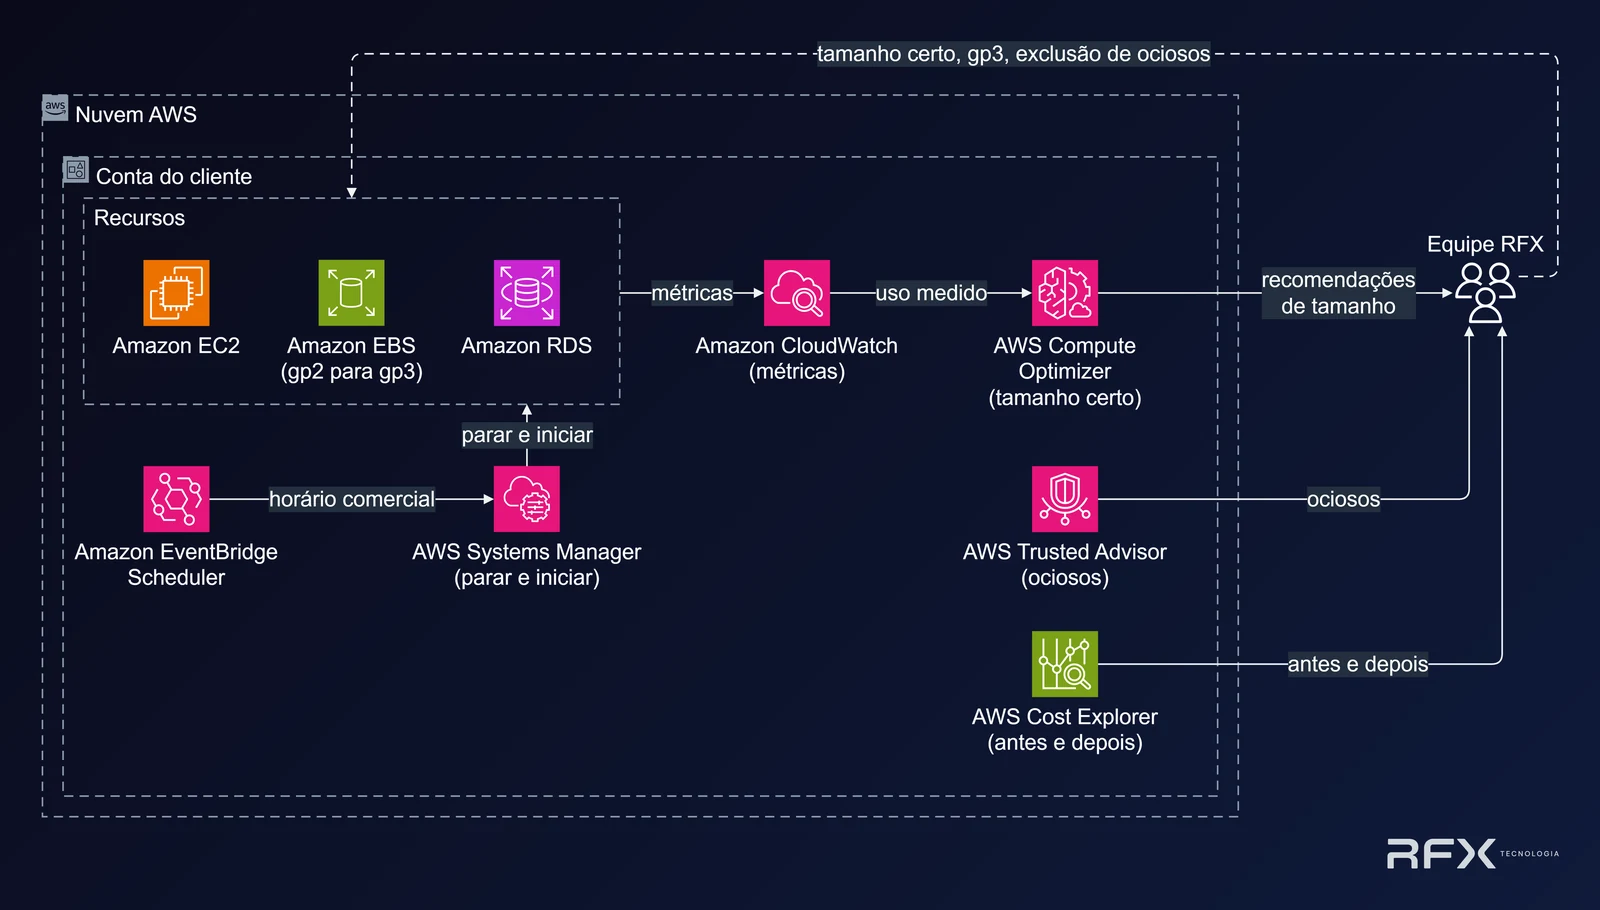
Componentes e fluxos deste diagrama
- Nuvem AWS, conta do cliente: Amazon CloudWatch, AWS Compute Optimizer, Amazon EC2, Amazon EBS, Amazon RDS, AWS Trusted Advisor, Amazon EventBridge Scheduler, AWS Systems Manager e AWS Cost Explorer.
- Fora da conta: Equipe RFX.
- Amazon EC2, Amazon EBS e Amazon RDS enviam métricas ao Amazon CloudWatch, que alimenta o AWS Compute Optimizer.
- AWS Compute Optimizer envia recomendações de tamanho à Equipe RFX; AWS Trusted Advisor envia a lista de ociosos.
- Equipe RFX aplica tamanho certo, gp3 e exclusão de ociosos nos recursos da conta (tracejado).
- Amazon EventBridge Scheduler aciona o AWS Systems Manager no horário comercial; o Systems Manager para e inicia EC2 e RDS.
- AWS Cost Explorer devolve à Equipe RFX a comparação antes e depois.
Ganhos: o que medimos no projeto
| Indicador | Como medimos | O que muda |
|---|---|---|
| Custo mensal de Amazon EC2, Amazon EBS e Amazon RDS | AWS Cost Explorer, por serviço, mesmo número de dias antes e depois | De custo fixo herdado para custo ajustado ao uso |
| Recursos com recomendação de redução pendente | Contagem no AWS Compute Optimizer | De dezenas de recomendações ignoradas para fila tratada mensalmente |
| Recursos ociosos | Contagem por tipo (volumes, IPs, balanceadores, instâncias paradas) no Trusted Advisor, no Cost Optimization Hub e no inventário da RFX | De inventário desconhecido para zero ociosos sem justificativa |
| Horas ligadas de dev, teste e homologação | Horas de instância por mês, antes e depois do agendamento | De 24x7 para o horário em que o time trabalha |
| Incidentes de desempenho após a mudança | Chamados e alarmes no período de observação | Zero regressão é o critério de sucesso de cada onda |
Indicadores de um projeto típico, medidos no próprio projeto: resultado típico, não garantia.
Escopo e entregáveis por fase
| Fase | O que acontece | Entregáveis | Duração |
|---|---|---|---|
| 1. Medir | Agente do CloudWatch e Performance Insights onde faltam, leitura do Compute Optimizer, inventário de ociosos, validação com os donos | Plano de ondas com janela e rollback por recurso | Semanas 1 e 2 |
| 2. Primeira onda | Dev, teste e apoio: tamanho certo, gp3, agendamento, exclusão de ociosos | Ambientes fora de produção ajustados; agenda em operação | Semanas 3 e 4 |
| 3. Produção | Produção em janela, um sistema por vez, observação de 7 dias cada | Produção ajustada; relatório antes e depois | Semanas 5 e 6 |
| 4. Segundo ciclo | Nova leitura do Compute Optimizer, ajuste fino, entrega da rotina ao time do cliente | Checklist dos itens Tamanho certo e Ociosos operando | Semanas 7 e 8 |
Durações típicas, em faixa. O plano do projeto fixa as datas reais.
Algo a mais: instâncias de geração atual na mesma troca de tamanho
Ao trocar o tamanho, a RFX avalia também a troca de geração de instância (processadores mais novos, inclusive AWS Graviton quando o sistema operacional e a aplicação permitem) e a migração de volumes gp2 para gp3, que acontecem dentro da mesma arquitetura.
O que entra nesta avaliação
- Família e geração de instância.
- Tipo de volume Amazon EBS.
- Classe de instância Amazon RDS.
- Horário de funcionamento.
O que fica para o catálogo de migração e modernização
- Trocar o banco de dados.
- Levar a aplicação para contêineres.
- Redesenhar em serverless.
Perguntas frequentes deste exemplo
Cada mudança tem janela e rollback: voltar ao tamanho anterior leva uma parada curta. Antes da produção, passamos pelos ambientes de apoio e observamos 7 dias por sistema. A decisão de redução vem de métricas medidas no seu ambiente.
Muda o tamanho, o tipo de volume e o horário. O desenho continua o mesmo.
Instâncias Amazon RDS podem ficar paradas por até 7 dias seguidos e são reiniciadas automaticamente depois disso; a agenda respeita essa regra e religa toda manhã útil.
Volume com dado recebe snapshot antes da exclusão e o snapshot entra numa política de retenção. Volume sem dado identificável é apagado com registro de quem autorizou.
O Cost Optimization Hub funciona em qualquer plano de suporte e aponta instâncias, grupos de Auto Scaling, volumes, bancos e NAT gateways ociosos. IPs elásticos sem associação e balanceadores sem destino vêm das verificações de custo do AWS Trusted Advisor, disponíveis nos planos Business Support+, Enterprise Support e Unified Operations. Nos demais planos, e para instâncias paradas e snapshots órfãos, a RFX levanta o inventário diretamente na conta.
Serviços AWS deste exemplo
- AWS Compute Optimizer
- Amazon CloudWatch
- Amazon EC2
- Amazon EBS
- Amazon RDS
- AWS Trusted Advisor
- Cost Optimization Hub
- Amazon EventBridge Scheduler
- AWS Systems Manager
- AWS Cost Explorer
- AWS Graviton (variante)
Incentivos AWS
A RFX busca para o projeto os programas de incentivo e créditos da AWS aplicáveis, sempre sujeitos a aprovação da AWS.