Escopo do projeto
Descoberta funcional e técnica da aplicação atual (módulos, integrações, picos, dados). Desenho da arquitetura alvo e do modelo de dados para acesso por chave. Estratégia de transição por módulo: o módulo novo entra ao lado do legado, com roteamento gradual na borda, até o legado ser desligado.
Implementação do primeiro módulo com infraestrutura como código, pipeline de entrega e ambientes separados (desenvolvimento, homologação, produção). Login e perfis de acesso em diretório gerenciado. Observabilidade (métricas, logs, alarmes) e orçamento com alerta desde o primeiro dia.
Operação assistida e transferência de conhecimento para o time de desenvolvimento, que passa a evoluir o produto.
Desafio e problemas de hoje
- Aplicação em dois ou três servidores sempre ligados, pagos no pico mesmo de madrugada.
- Atualizar em produção dá medo: janela, pessoa de plantão e rollback manual.
- Patch de sistema operacional e de runtime atrasados porque falta tempo.
- Picos de acesso (campanha, matrícula, fechamento) derrubam o sistema.
- Login e permissões implementados à mão, difíceis de auditar.
- Time pequeno de desenvolvimento, com operação compartilhada entre todos.
O ambiente de partida (perfil típico deste exemplo)
| Item | O que costuma existir |
|---|---|
| Aplicação | Portal web ou sistema interno em monólito (.NET, Java, PHP ou Node.js), de 2 a 4 servidores (web e aplicação) |
| Banco | Relacional em servidor próprio ou Amazon RDS; tabelas de sessão e log misturadas às de negócio |
| Usuários | De centenas a dezenas de milhares, com picos sazonais |
| Integrações | API de terceiros (pagamento, notas, mensageria), importação por arquivo, e-mail transacional |
| Dependências | Sessão em memória do servidor, arquivos locais, tarefas agendadas no próprio servidor |
| Restrições | Janela de parada inexistente em horário comercial; dados pessoais sob LGPD; time pequeno de desenvolvimento |
Perfil típico, com faixas, construído a partir de projetos desse tipo. O inventário real é o primeiro entregável do diagnóstico.
Requisitos
- R1Sistema operacional, runtime e patch ficam com o serviço gerenciado.
- R2Escalar no pico e custar pouco fora dele.
- R3Atualizações frequentes e seguras, com reversão rápida.
- R4Login, perfis e MFA com diretório gerenciado, no lugar de código próprio de autenticação.
- R5Tarefas assíncronas (e-mail, integração, relatório) fora do caminho da requisição.
- R6Observabilidade e orçamento com alerta desde o primeiro dia.
- R7Transição por módulo, convivendo com o legado.
O que desenhamos para cada requisito
| Requisito | Decisão de arquitetura | Serviço AWS |
|---|---|---|
| R1 | Site estático em armazenamento de objetos, API em funções sob demanda, dados em banco gerenciado serverless | Amazon S3, AWS Lambda, Amazon DynamoDB |
| R2 | Entrega global com cache de borda; funções e tabela escalam por demanda e cobram pelo uso | Amazon CloudFront, AWS Lambda, Amazon DynamoDB |
| R3 | Infraestrutura como código, pipeline por ambiente, versões e aliases de função com troca gradual de tráfego | AWS SAM ou AWS CDK, AWS Lambda |
| R4 | Diretório de usuários gerenciado com MFA, perfis em grupos e tokens validados na API | Amazon Cognito, Amazon API Gateway |
| R5 | Eventos de negócio publicados num barramento e consumidos por funções separadas, com fila e repetição | Amazon EventBridge, Amazon SQS, AWS Lambda |
| R6 | Métricas, logs estruturados e alarmes por função e por API; orçamento mensal com alerta | Amazon CloudWatch, AWS Budgets |
| R7 | Roteamento por caminho na borda: módulos novos para a API serverless, demais para o legado, até concluir | Amazon CloudFront, Amazon API Gateway |
Arquitetura
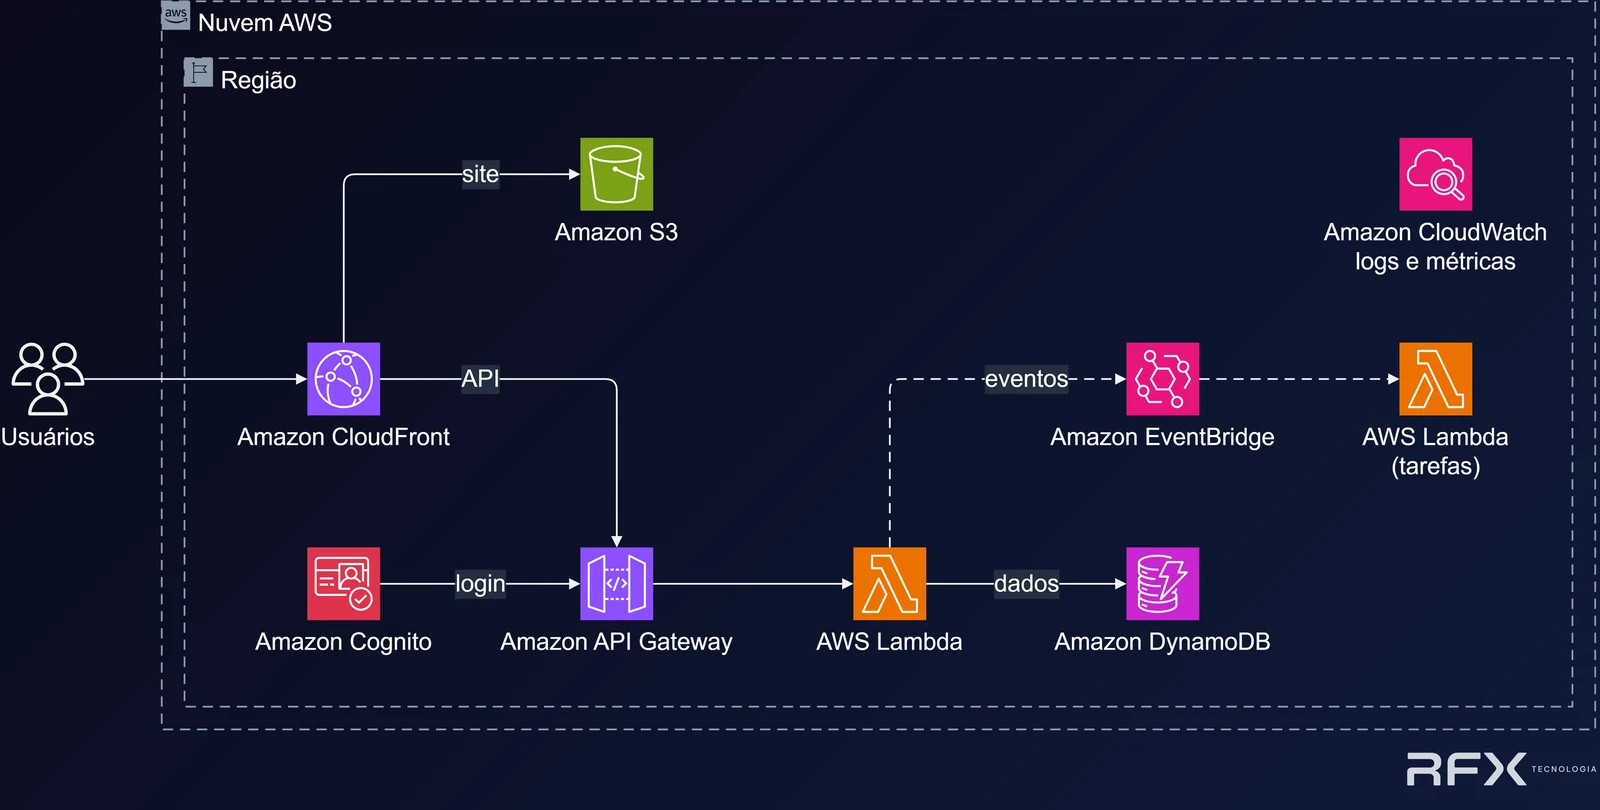
Componentes e fluxos deste diagrama
- Usuários: acessam pelo Amazon CloudFront.
- Amazon CloudFront: entrega o site a partir do Amazon S3 e encaminha a API para o Amazon API Gateway.
- Amazon Cognito: login validado pelo Amazon API Gateway.
- Amazon API Gateway: chama o AWS Lambda.
- AWS Lambda: executa o código e grava os dados no Amazon DynamoDB.
- Amazon EventBridge: recebe os eventos do AWS Lambda e dispara o AWS Lambda (tarefas).
- Amazon CloudWatch: logs e métricas de todos os componentes.
Ganhos: o que medimos no projeto
| Indicador | Como medimos | O que muda |
|---|---|---|
| Servidores a administrar | Contagem de servidores com sistema operacional e runtime sob responsabilidade do time | De 2 a 4 servidores no perfil típico para zero servidores sob responsabilidade do time no módulo migrado |
| Frequência de atualização | Implantações em produção por semana e tempo de reversão | De janela planejada com plantão para implantações pequenas e frequentes, com reversão rápida para a versão anterior |
| Custo fixo e variável | Parcela da fatura que varia com o uso, em meses de pico e de baixa | De custo fixo pelo pico para custo que acompanha o uso |
| Comportamento no pico | Erros e tempo de resposta (p95) em campanhas ou fechamentos | De queda no pico para escala automática, medida por alarme |
| Horas de operação | Horas por mês em patch, reinício e monitoramento manual | De operação de servidor para evolução do produto |
Indicadores de um projeto típico, medidos no próprio projeto: resultado típico, não garantia.
Escopo e entregáveis por fase
| Fase | O que acontece | Entregáveis | Duração |
|---|---|---|---|
| 1. Descoberta | Mapa de módulos, integrações, picos e dados; escolha do primeiro módulo | Documento de descoberta, arquitetura alvo, modelo de dados, plano de transição | de 1 a 2 semanas |
| 2. Fundação | Contas e ambientes, infraestrutura como código, pipeline, login, observabilidade, orçamento | Pipeline funcionando nos três ambientes, diretório de usuários, painéis e alarmes | de 2 a 3 semanas |
| 3. Primeiro módulo | Implementação, testes, migração dos dados do módulo, roteamento gradual | Módulo em produção ao lado do legado, relatório de testes | de 4 a 8 semanas |
| 4. Operação assistida e transferência | Ajustes, documentação, sessões com o time de desenvolvimento, plano para os próximos módulos | Documentação, runbook, backlog dos próximos módulos | de 1 a 3 semanas |
Durações típicas, em faixa. O plano do projeto fixa as datas reais.
Algo a mais: quando a rota é contêiner, e quando é serverless
Se a aplicação precisa continuar como está por enquanto, mas pode ser empacotada, o caminho é contêiner no Amazon ECS com AWS Fargate (ou Amazon EKS quando o time já opera Kubernetes), com a mesma lógica de pipeline, observabilidade e orçamento: é o caso Aplicação em contêineres.
Sinais para contêiner
- Dependência de framework ou biblioteca com estado em memória.
- Processos longos que ultrapassam o tempo de execução de uma função.
- Equipe que já usa Docker.
Sinais para serverless
- Tráfego com picos.
- Integrações por evento.
- Time pequeno com operação compartilhada.
Perguntas frequentes deste exemplo
A transição é por módulo: o novo entra ao lado do legado, com roteamento gradual, e o legado só desliga quando o último módulo migrar.
O AWS Lambda tem suporte a várias linguagens e a contêineres. O que decide é a forma da aplicação (estado, tempo de execução, dependências), avaliada na descoberta.
Serviços sob demanda cobram pelo uso; fora do pico, o custo acompanha. O orçamento com alerta é configurado no primeiro dia para que qualquer desvio apareça cedo.
Pode continuar, no Amazon RDS ou Amazon Aurora, acessado pelas funções. O Amazon DynamoDB entra onde o padrão de acesso por chave faz sentido; a decisão é por módulo.
Serviços AWS deste exemplo
- Amazon CloudFront
- Amazon S3
- Amazon API Gateway
- Amazon Cognito
- AWS Lambda
- Amazon DynamoDB
- Amazon EventBridge
- Amazon SQS
- Amazon CloudWatch
- AWS Budgets
- AWS SAM ou AWS CDK
- Amazon ECS (variante)
- AWS Fargate (variante)
- Amazon EKS (variante)
- Amazon RDS (variante)
- Amazon Aurora (variante)
Incentivos AWS
A RFX busca para o projeto os programas de incentivo e créditos da AWS aplicáveis, sempre sujeitos a aprovação da AWS.